10年以上書きためてきたブログ記事をAIに読み込ませて、過去記事の分析やリライトに役立てたい。
そう思い立ち、WordPressの記事データをGitHubへ保存する仕組みを作りました。私はエンジニアではないので、AIコーディングツールに手伝ってもらいながら作ったものです。
ところが、いざ動かし始めてみると困ったことになりました。本来は記事をAIに読ませるための仕組みなのに、気づけばその同期作業のメンテナンスばかりに追われていたのです。
記事を直したいのに、同期でつまずき、確認と修正に3時間ほどかかったこともありました。完全に目的を見失っていました。
そこで、もっと楽に同期できるよう仕組みを見直すことにしました。ただ、詳しく調べていくうちに、思わぬ落とし穴が見つかったのです。
非エンジニアの私が試行錯誤した記録をまとめてみます。
WordPressに最初から備わっていた「勝手口」
そもそも、なぜGitHubに記事を保存したかったのかというと、過去記事の分析とリライトが目的でした。
長くブログを書いていると、昔の記事の情報が古くなっていたり、似たような内容を別の記事でも書いていたりと、全体の整合性を取るのが難しくなってきます。
AIに記事を見直してもらうなら、1本の記事だけでなく、「過去に書いたあの記事と矛盾がないか」「関連記事はあるか」といった文脈まで一緒に見てもらいたい。
ただ、何千本もある記事をWordPressの管理画面から1本ずつコピーしてAIに貼り付けるのは、とてもやっていられません。
WordPressには標準のエクスポート機能(XML)がありますが、私が欲しかったのはAIが扱いやすいMarkdown形式のテキストでした。そういうプラグインも探したのですが、うまく動くものがなかなか見つかりませんでした。
何かいい方法がないか探し続けること約半年。とうとう見つけました。その名も「WordPress REST API」。
WordPressには、外部から記事データを取り出すための仕組みが最初から用意されていたのです。いやいや、WordPressのデフォルトの機能であるんかーい。10年も使っていたのに、まったく知りませんでした。
しかもこれ、公開済みの記事をログイン情報なしで取得できるのです。すごいような、怖いような。まぁネットに公開するってそういうことですもんね。
で、さらにすごいのが、このWordPressの過去記事をGitHubに置いちゃえば、それ以降の変更履歴も残していけるんです。以前取得した記事と今の記事を比較できるのも便利です。
ということで、CodexやClaude Codeに指示を出して、WordPress REST APIで取得したデータをMarkdownに変換してGitHubへ保存するプログラムも作ってもらいました。
コードを書けない自分でもここまで形にできたのは、本当にありがたいことでした。
この仕組みのおかげで、過去記事の分析やリライト自体はかなりスムーズに進むようになりました。だからこそ、もっと普段からストレスなく使えるようにしたかったのです。
作れた。でも、使い続けるのが大変だった
WordPressから記事を取り出してGitHubに保存する。ここまではうまくいきました。
ただ、ブログは新しい記事を書いたり、古い記事を直したりします。そのたびにGitHub側のデータも最新にしておかないと、AIが古い情報をもとに的外れな分析をしてしまいます。
つまり、定期的に「同期」を走らせる必要があります。
記事を取得して、Markdownを生成し直し、一覧や内部リンクの情報も更新する。この一連の作業をCodexに任せていたのですが、これが毎回すんなり終わってくれません。
15分ほどで終わる日もあれば、途中でうまくいかなくなり、確認と修正を繰り返しているうちに3時間ほどかかったこともあります。Codexの使用量も無駄に使っちゃいます。
AIを使ってサクッと同期して、サクっと分析させるはずが、いつの間にやら同期システムのメンテナンスにイライラする状況になっていました。
更新された記事だけ取ればいい、と思ったけれど
そこでまず考えたのが、「毎回全記事を取り直すのをやめる」ことでした。
WordPressの記事には更新日時が記録されています。それなら、前回の同期以降に更新された記事だけを取得すれば、かなり時間を節約できるはずです。
たとえば3,000本のうち、直したのが5本だけなら、その5本分だけを取得すればいい。
実際にテストすると、全記事の一覧と少数の記事を取得するだけなら約10秒でした。一方、記事の本文まですべて取り直すと約11分。取得するデータ量は違いますが、この差を見ると、更新された記事だけ取得する方法が魅力的に思えました。
普段は差分だけを取って、たまに全件を取り直せばいいんじゃないか。そう思って実装しようとしました。
ただ、ひとつ気になることがありました。
「更新日時だけを見ていて、本当に変更の取りこぼしはないのか?」
念のため、手元に保存してある記事と、新しくAPIから取得した記事のデータをAIに突き合わせてもらいました。
すると、予想していなかった事実が分かったのです。
記事を更新していないのに、中身が変わっていた
検証してみたところ、WordPress上の更新日時は変わっていないのに、APIから返ってくるデータに差分が出ている記事が48件も見つかりました。
48件のうち47件は商品リンク(商品カード)に関係する変化で、残り1件は外部サイトのリンクプレビューのタイトルに関係する変化でした。
もちろん、自分が書いた本文のテキストが勝手に変わっていたわけではありません。実際のブラウザ画面を比較したわけでもなく、あくまでAPIが返したデータ同士の比較です。
変わっていたのは、WordPressが表示用に組み立てるHTML(REST APIの content.rendered というデータ)でした。WordPressは、保存されている元のテキストをそのまま返すだけでなく、プラグインなどの処理を通して、表示用のHTMLに変換してから出力します。今回のデータには、商品カードの価格表記やリンクURLなどに関係する差分が含まれていました。
つまり、「記事の更新日時が変わっていないからといって、取得できる本文データまで同じとは限らない」ということです。
もし更新日時だけを信じて差分取得をしていたら、こうした変更をごっそり見落とすところでした。
賢い仕組みより、自分で面倒を見切れる仕組みを選ぶ
では、商品カードの変更まで毎回拾う必要があるのかというと、そこは悩ましいところです。
本来の目的は記事本文の分析やリライトなので、商品カードの価格が変わったかどうかは、正直どうでもいい情報かもしれません。
ただ、私の仕組みでは本文だけでなく「記事内のリンク関係」も抽出して整理していました。商品カード内のリンクが変われば、私が作っているリンク索引にも影響する可能性があります。
問題は、必要な変更と不要な変更を、更新日時だけで自動判別するのは難しい点でした。
もちろん、「商品カードの差分は無視する」といった除外ルールを作り込むこともできます。
でも、ルールを複雑にすればするほど、不具合が起きたときの原因調査も大変になります。そして、そのトラブルを解決しなければいけないのは、コードを一から書けない自分自身です。
AIに直してもらうにしても、何が起きているのかを把握して検証する手間は残ります。もともと「同期の手間を減らしたい」と思っていたのに、これでは余計に管理コストが増えてしまいます。
そこで、方針をガラッと変えました。
差分だけをうまく抜き出すような仕組みはやめて、「全部取り直す処理そのものを速くできないか」と考えたのです。
全部取り直しても、十分速くできた
私が管理しているブログは、複数のWordPressサイトに分かれています。
これまでは、サイトAの記事をすべて取り終わってからサイトBへ、その次にサイトCへ、と1サイトずつ順番に処理していました。
そこで、別々のサイトに対しては同時に取得リクエストを送る形に変更しました。アクセスが集中しすぎないよう、異なるホストへのアクセスは最大3つまで並行させ、同じホストへのアクセスは1件ずつ、1秒の待機時間を設けて行っています。
この変更によって、これまで約11分かかっていた全件取得が、約6分前後で終わるようになりました。
取得する記事数は減らしていないのに、測定した範囲では処理時間を約4〜5割短縮できました。改善前後の測定日時は異なりますが、全件取得のまま時間を短くできたのは確かです。何より、「どの記事を取得して、どの記事を無視するか」といった複雑な判定ロジックを作らずに済んだのが一番の収穫でした。
指示を1回出したら、最後まで終わった
取得処理を速くできたので、実際の運用フローも整えました。
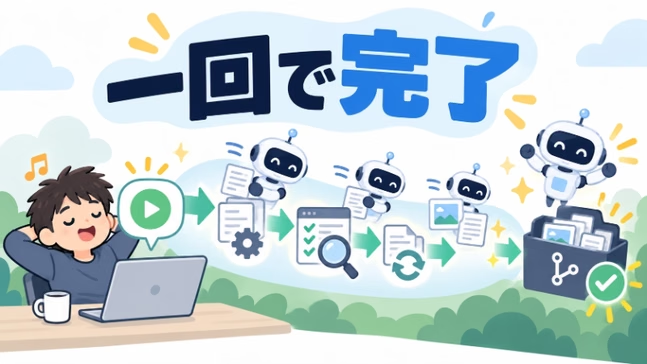
新しい記事を1本公開したあと、Codexに全記事の最新データを取得してGitHubを更新するよう指示を出しました。
ここで大事だったのは、途中で人間がチェックや指示を挟まなくても、最初から最後まで作業を完了できるかどうかです。いちいち指示するのめんどくさいですからね。
そのため、まずは変更内容をテスト確認(dry-run)し、問題がなければ本番の更新に進むこと。データの整合性をチェックし、GitHubへの反映まで確認すること。そして予期せぬエラーが出たら、無理に進めずストップすること。こうした一連の手順をあらかじめ決めておきました。
実際に試したところ、公開中の3,177件の記事を取得し、新規記事の追加からMarkdownの生成、リンク情報の更新、GitHubへの反映まで、一度の指示で完了しました。全工程にかかった時間は約21分でした。
先ほどの約6分というのは、別途測定した全件取得単体の目安です。この約21分には、予行演習から本番の取得、Markdownへの変換、検証、そして取得データとMarkdown・索引を2段階でGitHubへ反映するまでの全作業が含まれています。
なお、今回Codexが更新したのはGitHubにある分析用のコピーだけで、WordPressの公開記事自体は書き換えていません。また、これは実運用テストの1回の成功例であり、今後も毎回同じ時間で問題なく終わると保証されたわけではありません。
それでも、指示を一度出したあとは、完了するまで私が途中で対応する必要がなかったのは大きな前進でした。
AIで作れることと、無理なく使い続けられることは別物
今回の試行錯誤で特に大きな発見だったのは、「WordPressの記事の更新日時が同じでも、REST APIで取り出した表示用の本文は変わることがある」という事実でした。
もちろん、自分がどんなデータを保存したいかによって、適切な同期方法は変わります。誰もが毎回すべての記事を取り直す必要はありません。
ただ、AIと一緒に効率化を考えるときは、最初に思いついたスマートな案をそのまま採用するのではなく、実際のデータを使って反例がないか確かめてみることが大切だと学びました。
今後、似たような場面に出会ったら、AIにこう聞いてみようと思います。
「そのやり方で、何か見落としや例外は出ませんか? 実際のデータを使って確認してください」
コードが書けなくても、AIに前提を疑ってもらうことはできます。
AIツールを使えば、これまで自分には作れなかったような仕組みも作れるようになりました。でも、「作れること」と「自分が無理なく管理し続けられること」は別です。
スマートに見える近道を探すより、シンプルで力技な仕組みを高速化する。非エンジニアの自分にとっては、そちらのほうがずっと扱いやすいやり方でした。
*関連記事
- 私がWordPressの記事管理でNotionを使うのをやめた理由
- AI時代にWordPressブログは古いのか|捨てずに「閉じ込めない」運営術
- 非エンジニアこそMarkdownを使うべき理由|AIに読ませやすいメモの残し方
コメント