AI時代になってから、Cloudflareを触る機会が一気に増えました。
以前からWordPressのDNSやCDNなどで名前は知っていましたが、最近はWorkersやR2、AI関連の機能など、さまざまな場面でCloudflareを使うようになっています。
そして、触れば触るほど思うようになりました。
「Cloudflareって、すげぇ会社だな……」
最初は「Webサイトを速くしたり、攻撃から守ったりするCDNの会社」くらいに思っていたのですが、調べてみると現在のCloudflareはまったくそれだけではありません。
企業ネットワーク、開発基盤、ストレージ、データベース、AI推論、AIエージェント、さらにWebコンテンツとAIクローラーの関係にまで関わっています。
では、Cloudflareとはそもそもどんな会社なのでしょうか。そして、なぜここまで幅広い領域へ進出できたのでしょうか。
気になって創業前から現在までを調べてみたので、この記事でまとめます。
その歩みを追ってみると、脈絡なく別の分野へ手を広げたのではなく、「通信の経路上に位置する」という一貫した強みを拡張してきた会社だということが分かりました。
Cloudflareの歴史は、「見る」「止める」「肩代わりする」「仕分ける」という4つの段階で考えると分かりやすくなります。
Cloudflareは「インターネットの途中」にいる
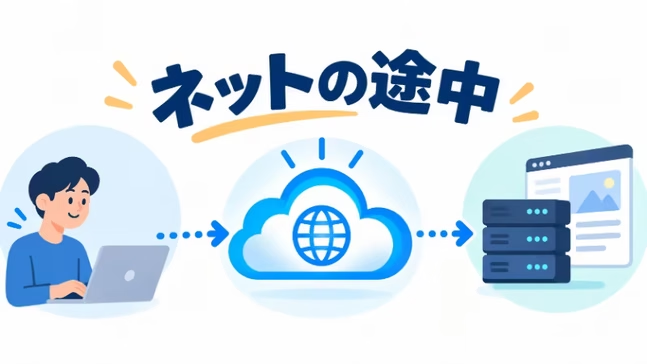
まず、Cloudflareの基本的な仕組みを整理しておきます。
通常のWebサイトでは、利用者は目的のWebサーバーへ直接アクセスします。
利用者 → Webサーバー
Cloudflareを導入すると、その間にCloudflareが入ります。
利用者 → Cloudflare → Webサーバー
この中間にいることで、サイバー攻撃がサーバーに届く前に遮断したり、キャッシュを利用して利用者の近くからデータを高速に返したりできます。現在では、この経路上でプログラムやAIモデルの実行まで行えるようになりました。
公式発表によると、Cloudflareのネットワークは世界335都市、125カ国以上に展開され、Web全体のHTTPトラフィックのおよそ2割をプロキシしています。13,000を超えるISP、クラウド、企業ネットワークと相互接続していることも公表されています。
Cloudflareの資産は、個別の機能や製品というより、地球規模で張り巡らされた巨大なネットワーク基盤そのものです。
「見る」:スパム業者の観察から始まった原点
歴史は会社設立前の2004年にさかのぼります。
後にCloudflareを共同創業するMatthew PrinceとLee Hollowayは、スパム業者がどこからメールアドレスを収集しているのかを調べるため、「Project Honey Pot」を立ち上げました。Webサイトに仕掛けを置き、悪質なBotやスパマーの挙動を観測するプロジェクトです。
世界185カ国以上、数千のサイトが参加する規模へ成長する中で、参加者から「悪質な相手を特定するだけでなく、アクセスそのものを止めてほしい」という要望が繰り返し寄せられるようになりました。
2009年、Princeはハーバード・ビジネス・スクールでMichelle Zatlynと出会い、Hollowayを加えた3人で起業に向けて動き出します。最初の事業計画には「Project Web Wall」という仮称が付けられていました。その後、「クラウド上のファイアウォールを作るならCloudflareでは」と知人から提案され、現在の社名になりました。
「止める」:防御と高速化の両立
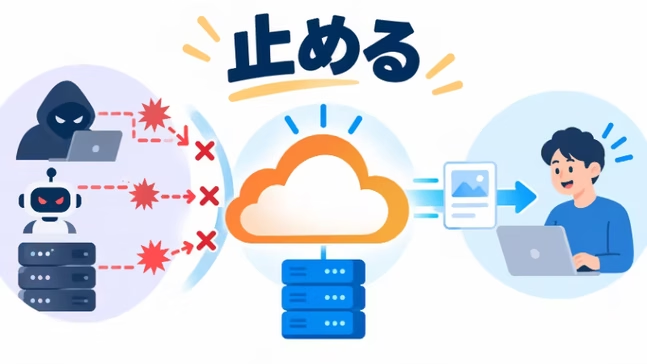
2010年、CloudflareはProject Honey Potの参加者を中心にプライベートβ版の提供を開始しました。
創業当初は、サイトと利用者の間にサービスを挟むことで通信速度が落ちるのではないかと心配されていました。
ところが結果として、ページの読み込み速度が平均30%向上したという報告が届きます。攻撃などの不要な通信を手前で取り除き、画像などの静的コンテンツをネットワーク側でキャッシュして返したためです。
自社推計の数値ではあるものの、今も続く基本形が、ここで生まれました。守ることと速くすることを、同じネットワークで同時に行う仕組みです。同年のTechCrunch Disruptで一般公開されます。
2014年には「Universal SSL」を発表し、無料プランにもHTTPSを提供しました。
初期の無料版Flexible SSLでは、Cloudflareから元のWebサーバーまでの通信が暗号化されない課題もありましたが、個人や小規模サイトにもHTTPSが広がる大きなきっかけになりました。
「肩代わりする」:通信の中継からサーバー処理そのものへ
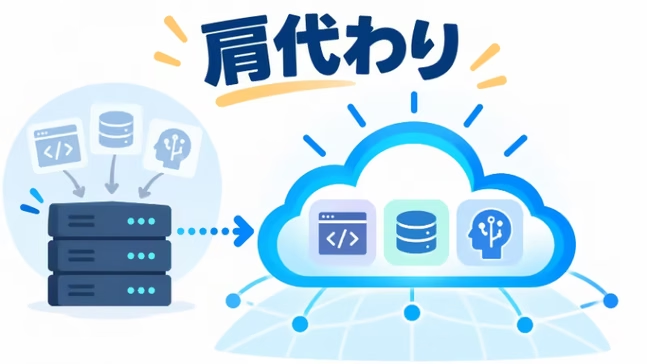
大きな転換点となったのが、2017年に発表された「Cloudflare Workers」です。
それまでの役割は、受け取った通信を検査してWebサーバーへ中継することでした。Workersの登場により、利用者が記述したプログラムそのものをCloudflareのネットワーク上で直接実行できるようになります。配信会社から、分散アプリケーションを実行できるプラットフォームへと踏み出した瞬間でした。
2018年4月1日には、高速でプライバシーを重視したパブリックDNS「1.1.1.1」を公開しました。Cloudflareによると「1が4つだから4/1」という理由でこの日を選んだため、エイプリルフールの冗談ではないと記者に何度も説明することになったそうです。
2020年には社内システムやテレワークの通信を守る「Cloudflare One」(Zero Trustサービス)を展開し、Webサイトの前だけでなく、企業ネットワークの入口にも立つようになります。
2021年には、オブジェクトストレージ「R2」を発表しました。従来のクラウドで大きな負担となっていたデータ転出料金(エグレス料金)をゼロにしたことで注目を集めます。
世界各地の通信事業者と直接接続しているため、帯域コストを抑えやすい構造を持っています。AWSのように巨大なデータセンターを中心に網を広げたアプローチとは対照的に、先に世界規模の通信網を敷き、その経路上にサーバーやストレージを分散配置したのがCloudflareの形です。
そして「肩代わりする」仕事は、AIにまで広がります。
2023年には「Workers AI」を発表し、Cloudflareのネットワーク上でAIモデルを動かせるようになりました。2025年11月に買収を発表し、12月に正式にCloudflare傘下となったAIモデル実行サービスのReplicateも加わり、CloudflareはAIの実行基盤としても領域を広げています。
「仕分ける」:AI時代におけるアクセスの選別
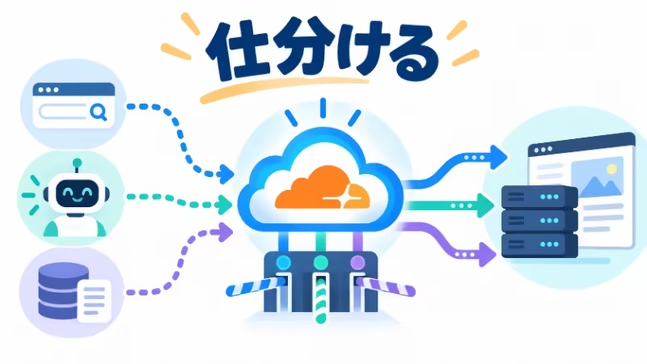
AI時代にCloudflareが特に力を入れているのが、Webサイトに来るアクセスの選別です。
2025年7月、Cloudflareは新規登録ドメインにおいて、AI学習目的のクローラーを初期設定で遮断する方針を打ち出しました。
検索エンジンは、ページを読む代わりに検索結果から読者を送り返してくれます。ところがAIクローラーの中には、大量にページを取得しても元サイトへ人をほとんど送り返さないものがあります。Cloudflare自身の分析でもこの傾向が示されており、出版社などからは、この不均衡への不満が強まっていました。
同月には、サイト運営者がAIクローラーに対してコンテンツ利用料を請求できる仕組み「Pay Per Crawl」も発表されました。長らく実用例の少なかったHTTPステータスコード「402 Payment Required」を活用した設計です。
ただし、2026年10月現在もPay Per Crawlはクローズドベータです。誰でも使える一般的な仕組みになったわけではありません。
AIクローラー制御の仕組み整理
Cloudflareが提供するAIトラフィック制御には、目的が異なる仕組みが存在します。
2025年9月発表の「Content Signals Policy」は、robots.txtを用いて検索、AI入力、AI学習といった目的ごとに、許可や拒否の意思を機械的に表明する仕組みです。
対して、2026年7月導入の「Search・Agent・Training」は、Cloudflareのネットワーク側で通信そのものを目的別に分類して制御する仕組みです。
Searchは検索、Agentは人間の代わりに動くAIエージェント、Trainingはモデルの学習やファインチューニングを目的とする通信を指します。
さらに同年9月には、検索での発見性を保ちながらAI学習への利用を拒否する「Disallow AI Training」も追加されました。
意図を表明するContent Signalsと、現場で通信を実際に振り分けるSearch・Agent・Training。両者を組み合わせることで、単にアクセスを一括遮断するのではなく、誰が何の目的で来たのかを見分けて扱いを変える方向へ進んでいます。
クローラーの挙動を監視・指摘する立場
AIクローラー問題を象徴する出来事として、2025年8月にCloudflareがPerplexityの挙動をブログで公表した件が挙げられます。
Cloudflareは、サイト側からブロックされた後も、識別情報(User-Agent)や接続元を変更しながらクロールを続けていたと指摘しました。
Perplexity側からの反論もあり議論を呼びましたが、重要なのは、Cloudflareが通信の実態を広範囲に把握し、個別の企業名を挙げて公表できる位置にいる点です。
創業前にスパマーの動きを追っていた会社が、20年以上後にはAIクローラーの挙動を追っている。Cloudflareの原点が、形を変えて現在まで続いているようにも見えます。
コンテンツ保護とAI活用の両輪
CloudflareのAI戦略には興味深い特徴があります。
2026年1月には、コンテンツホルダーがAI企業へデータをライセンスしやすくする技術を持つHuman Nativeを買収しました。Web上のコンテンツを、ただ収集される対象ではなく、ライセンスして対価を得られる資産として扱う方向へ踏み込んでいます。
その一方で、自社ネットワーク上でAIを動かしたい開発者にはWorkers AIなどを提供しています。
Cloudflareは、AIにコンテンツを使わせたくないサイト運営者にも、AIを動かしたい企業にもサービスを提供しています。両者の利害がぶつかる場所そのものにCloudflareが立ち始めているわけです。
Cloudflareにとって事業の幅が広がる一方、一企業がAIとWebの関係にどこまで大きな影響力を持つべきかという課題も浮かび上がります。
サイト構築からAI利用までカバーする領域拡大
2026年にはWeb開発レイヤーへの進出も加速しました。
WebフレームワークのAstro開発チームを迎え入れ、ViteやVitestなどを手掛けるVoidZeroを買収しました。これにより、サイト完成後の配信だけでなく、開発初期の段階から開発者との接点を持つことになります。
AstroやViteについては、今後も特定のクラウドに縛られないオープンソースとして維持する方針が示されています。
さらに、新しいブラウザ標準であるWebMCPにCloudflareが対応し、Cloudflare利用サイトへWebMCPインターフェースを追加するDeveloper Previewを開始しました。
Webサイトを構築し、配信し、AIが利用するところまで、Cloudflareが関わる範囲はさらに広がっています。
無料プランが成立するビジネスモデル
これだけのインフラを持ちながら無料プランを提供できるのには、ちゃんと理由があります。
Cloudflareは、ネットワーク上の余剰能力を無料ユーザー向けに割り当てています。無料利用者が増えて通信規模が拡大するほど、世界各国のISPにとってもCloudflareと直接相互接続するメリットが大きくなり、結果として接続や設備のコストを抑えやすくなります。
また、無料ユーザーを含む多くのサイトから流れる多様なトラフィックは、新しい攻撃や異常を早期に発見するための知見にもつながります。
無料プランは単なる「お試し」ではなく、Cloudflareのネットワークそのものを大きくする仕組みの一部でもあるわけです。
業績拡大とAI移行への賭け
Cloudflareは2019年にニューヨーク証券取引所へ上場しました。ティッカーは「NET」です。
2025年の売上高は約21億7,000万ドルで、前年比約30%増。2026年第2四半期も売上高6億9,610万ドル、前年同期比36%増と高い成長を続けています。
ただしGAAPベースでは営業赤字が続いており、2026年5月には自社組織をAI前提の体制へ刷新するとして、人員の約20%削減を発表しました。
AIへの積極的な投資や組織変革が、中長期的な収益性につながるかどうかは、まだ分かりません。
巨大な共通基盤が抱える障害リスクと社会的責任
世界中に展開された共通インフラは、トラブルが起きたときの影響も大きくなります。
2025年11月18日、Cloudflareで大規模な障害が発生し、XやChatGPTをはじめ、Cloudflareを利用する多数のサービスがつながりにくくなりました。
原因は外部からの攻撃ではなく、Bot対策機能(Bot Management)が使う設定ファイルでした。データベースの権限変更をきっかけに、このファイルへ重複データが入り、サイズが想定の約2倍に膨らみました。
そのファイルがネットワーク全体へ配布された結果、中核システムが正常に処理できなくなったのです。
世界中へ一気に新機能を広げられるのはCloudflareの強みですが、同じ仕組みで不具合まで広範囲へ波及してしまう可能性があります。
もう一つ難しいのが、「誰の通信を止めるのか」という問題です。
2017年、Cloudflareは白人至上主義サイトDaily Stormerへのサービス提供を停止しました。CEOのMatthew Prince自身も、インフラ企業が一つの判断でWebサイトの可用性に大きな影響を与えられるほどの力を持つことに危機感を示しています。
その後も2019年の8chan、2022年のKiwi Farmsをめぐって、同じような議論が繰り返されました。
悪質なサイトを守れば批判される。止めれば「一企業がそこまで判断していいのか」と批判される。
インターネットの重要な通り道にいるからこそ、避けにくい問題です。
ブログ運営者は何を考えればいいのか
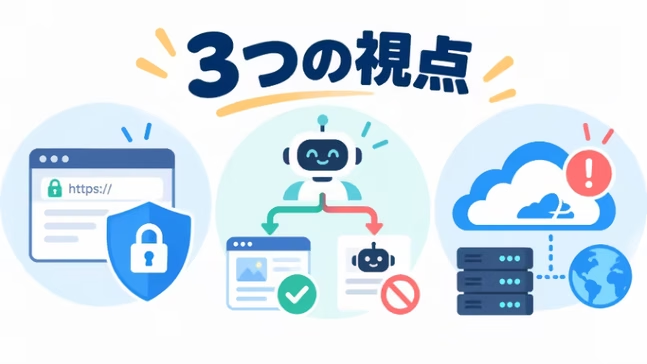
個人でWordPressなどを運営している場合も、Cloudflareは無関係ではありません。
まず確認したいのがSSL/TLSです。古い設定であるFlexibleのままでは、CloudflareとWebサーバー間の通信が暗号化されていない場合があります。
サーバー側にも有効な証明書があるなら、Full (strict)を利用してエンドツーエンドで暗号化することを検討した方がよいでしょう。
次にAIクローラーです。
「AIは全部ブロック」と一律に決めるのではなく、検索には出たいのか、AI検索から引用されたいのか、モデル学習には使わせたくないのか、といった目的を考えたうえで設定を選ぶ必要があります。
そして、Cloudflare自体も障害を起こすサービスだということです。
Cloudflareを導入すれば絶対に落ちなくなるわけではありません。便利さだけでなく、リスクも知ったうえで使うのが良さそうです。
まとめ:AI時代のWebの交通整理役を目指して
Cloudflareの歩みは、「通信の経路上に立つ」というポジションを活かし続けた進化の歴史です。
悪質な通信を「見る」ことから始まり、攻撃を「止める」仕組みを作り、本来サーバーが行っていた処理を「肩代わり」し、現在はAIと人間のアクセスを「仕分ける」ところまで来ました。
サイトを守りたい側とAIを展開したい側の両方にサービスを提供し、Web制作ツールにまで関わるようになった現在、私にはCloudflareが「AI時代のWebの交通整理役」を目指しているように見えます。
Pay Per Crawlをはじめ、まだ実験段階の取り組みもあります。AIを中心とした組織変革が成功するかも、これからです。
最初はCDNだと思っていたCloudflareが、今ではAIがWebをどう利用するかまで扱おうとしている。触れば触るほど「Cloudflareって、すげぇ会社だな……」と思う理由は、たぶんそこにあります。
※この記事は2026年10月5日時点のCloudflare公式資料、SEC提出資料、公式障害報告などを中心に確認しています。Cloudflare自身による将来構想、確認済みの事実、筆者による分析は区別して記載しています。
*関連記事
この記事ではCloudflareという会社そのものを見てきましたが、実際の設定や使い方についてもいくつか記事を書いています。
- Cloudflareでドメイン取得|設定から公開まで実体験で解説
Cloudflareでドメインを取得し、GitHubと連携してサイトを公開・自動デプロイするまでを実際に試した記録です。 - Cloudflare公式MCPをCodexとClaudeにつないだ
AIからCloudflareを扱える公式MCPを、CodexやClaudeへ接続して実際に試した経緯をまとめています。 - Next.jsは本当に下火?TanStack StartとCloudflareが注目される理由
Workers、Astro、Viteなど、CloudflareがWeb開発基盤へ広がっている流れをもう少し詳しく知りたい方向けです。 - WordPressのアクセス解析は何を使う?GA4・Jetpack比較
Cloudflare Web Analyticsを含め、WordPressで使えるアクセス解析サービスを比較しています。 - Contact Form 7でTurnstile後に迷惑メール増?対処法
Cloudflare TurnstileをWordPressの問い合わせフォームで実際に使ったときの問題と対処法をまとめています。
主な参考資料
- Cloudflare「Our Story」
https://www.cloudflare.com/our-story/ - Cloudflare「Introducing Universal SSL」
https://blog.cloudflare.com/introducing-universal-ssl/ - Cloudflare「Introducing Cloudflare Workers」
https://blog.cloudflare.com/introducing-cloudflare-workers/ - Cloudflare「Announcing 1.1.1.1」
https://blog.cloudflare.com/announcing-1111/ - Cloudflare「Introducing Cloudflare One」
https://blog.cloudflare.com/introducing-cloudflare-one/ - Cloudflare「Introducing Cloudflare R2 Storage」
https://blog.cloudflare.com/introducing-r2-object-storage/ - Cloudflare「Workers AI」
https://blog.cloudflare.com/workers-ai/ - Cloudflare「Cloudflare to acquire Replicate」
https://www.cloudflare.com/press/press-releases/2025/cloudflare-to-acquire-replicate-to-build-the-most-seamless-ai-cloud-for-developers/ - Cloudflare「Content Independence Day / Pay Per Crawl」
https://blog.cloudflare.com/introducing-pay-per-crawl/ - Cloudflare「Content Signals Policy」
https://blog.cloudflare.com/content-signals-policy/ - Cloudflare「AI traffic options: Search, Agent, Training」
https://developers.cloudflare.com/changelog/post/2026-07-01-ai-traffic-options/ - Cloudflare「Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives」
https://blog.cloudflare.com/perplexity-is-using-stealth-undeclared-crawlers-to-evade-website-no-crawl-directives/ - Cloudflare「Human Native is joining Cloudflare」
https://blog.cloudflare.com/human-native-joins-cloudflare/ - Cloudflare「Astro joins Cloudflare」
https://blog.cloudflare.com/astro-joins-cloudflare/ - Cloudflare「VoidZero is joining Cloudflare」
https://blog.cloudflare.com/voidzero-joins-cloudflare/ - Cloudflare「WebMCP Developer Preview」
https://blog.cloudflare.com/webmcp/ - Cloudflare「Accountable AI crawling / Disallow AI Training」
https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/ - Cloudflare「2025年11月18日の障害報告」
https://blog.cloudflare.com/18-november-2025-outage/ - Cloudflare「Why We Terminated Daily Stormer」
https://blog.cloudflare.com/why-we-terminated-daily-stormer/ - Cloudflare 2025 Form 10-K
https://www.sec.gov/Archives/edgar/data/1477333/000147733326000016/cloud-20251231.htm - Cloudflare 2026年第2四半期決算資料
https://www.sec.gov/Archives/edgar/data/1477333/000147733326000053/q226exhibit991.htm - Cloudflare 2026年5月7日 Form 8-K
https://www.sec.gov/Archives/edgar/data/1477333/000147733326000033/cloud-20260507.htm
コメント